【広告・PR】この記事には、アフィリエイトリンクを含む場合があります。掲載内容は2026年10月21日に公式情報を確認したものです。
こんにちは。AIあれこれ散歩道、運営者のもっちゃんです。
Perplexity Decisions APIは、文章や画像を質問に照らして分類・採点し、回答を説明文ではなく確率として返すAPIです。問い合わせの振り分け、投稿の審査、候補の評価など、「答えを長く書いてほしい」のではなく「決められた選択肢を一貫して判定したい」場面に向いています。
Perplexityは2026年10月19日に、27Bの標準モデルと4BのFlashモデルを含むpplx-decider v1.2を公開しました。最大128問を一度に尋ねられ、テキストと画像の両方を扱えます。ただし、確率が返るからといって、その数値が現実の正しさを保証するわけではありません。小さな検証データで誤り方を把握し、人が確認する境界を決めてから業務へつなぐ必要があります。
- 通常の生成AIとの違いと向いている用途
- 27B標準版と4B Flashの選び方
- 入力・質問・選択肢・確率の組み立て方
- 誤判定や偏りを増やさない検証手順
なお、この記事では有料APIを実行していません。応答速度、実際の請求額、日本語データでの精度は未検証です。公式Changelog、APIリファレンス、公開モデルカードで確認できた仕様と、導入時に自分で確かめる項目を分けて解説します。
Perplexity Decisions APIの仕組みと選び方
生成AIへ質問すると、普通は文章で回答が返ります。ところが業務システムが欲しいのは、長い説明ではなく「この問い合わせは営業・請求・技術のどれか」「この画像は基準を満たすか」「この文章を何点とするか」のような構造化された判断です。Decisions APIは、この判定部分へ用途を絞っています。
通常の生成AIと何が違うか
一般的なチャットモデルへ分類を頼む場合、JSONで返すよう指示しても、前置きや補足が混ざることがあります。アプリ側は文章を読み取り、欲しい値だけを抜き出さなければなりません。Decisions APIは、状態を表すstateと判定したいquestionsを渡し、各候補の確率やスコアを構造化された応答として返します。
たとえば、顧客メールを「請求」「技術」「その他」に振り分ける場面を考えます。チャットAIなら「このメールは請求に関する可能性が高いです」と文章で返すかもしれません。判定用APIなら、三つの候補へ数値を付けて返せるため、最上位を仮分類に使い、確信が弱いものだけ人へ回す仕組みを作りやすくなります。
公式は用途として分類とルーティング、ルーブリックによる採点を挙げています。「ルーブリック」は採点基準のことです。文章の分かりやすさ、画像の条件適合、申請内容の不足などを、あらかじめ決めた観点ごとに評価できます。
一言でいうと
文章を生成するAPIではなく、入力を決めた物差しで判定し、後続システムが扱いやすい数値を返すAPIです。
ただし、確率は「事実である確率」と同じではありません。モデルが選択肢の中でどれを支持したかを表す値です。入力が曖昧だったり、選択肢が重なっていたりすれば、高い数値でも判断を誤ることがあります。最初から自動承認へ直結させず、モデルの出力と正解データを比べる段階を設けてください。
三つの質問形式を使い分ける
APIリファレンスでは、質問の形式としてnoul、choice、scoreが示されています。名称は少し分かりにくいですが、役割は「自由な二択に近い判定」「複数候補からの選択」「数値の採点」と考えると整理しやすくなります。実装時は公式リファレンスの最新スキーマを確認してください。
choiceは、問い合わせ種別や文書カテゴリのように、候補が先に決まっている場面へ向きます。「営業」「請求」「技術」など、互いの境界を文章で定義しておくのがコツです。「その他」も用意して、無理に既存カテゴリへ押し込まないようにします。
scoreは、基準に沿って点数を付けたい場面に使えます。たとえば説明文の具体性を1〜5で評価する場合、1と5だけでなく中間点の意味も決めます。「3は必要事項を含むが具体例がない」のように物差しを言語化すると、担当者ごとの感覚差を減らせます。
noulを使う場合も、質問文を短くするだけでは足りません。「該当する」と「該当しない」の境界例を準備し、曖昧な入力をどう扱うか決めます。形式が違っても、良い判定の土台は、重ならない選択肢、具体的な基準、代表例、例外の四つです。
| 目的 | 向く形式 | 設計時の確認 |
|---|---|---|
| メールの部署振り分け | choice | カテゴリの重なりと「その他」 |
| 条件に当てはまるか | noul | 境界例と判断不能の扱い |
| 文章や画像の採点 | score | 各点数の具体的な意味 |
27B標準版と4B Flash
公式Changelogは、27Bの標準版と4BのFlash版を案内しています。標準版は精度を重視する選択肢、Flashは速度とコストを重視する選択肢です。APIでは、最新版を指すpplx-decider-latestとpplx-decider-flash-latest、特定版を固定するpplx-decider-v1.2とpplx-decider-flash-v1.2がリファレンスに掲載されています。
「大きいモデルなら常に正解」ではありません。毎日大量に来る定型メールの一次振り分けでは、Flashを使って低確信だけ人へ回すほうが、費用と待ち時間を抑えられる可能性があります。少数でも判断を誤ったときの影響が大きい審査では、標準版を候補にし、さらに人の確認を残すほうが安全です。
選び方は、同じ検証データを両方へ渡して比べます。全体の正解率だけでなく、見逃してはいけないカテゴリの再現率、確信が弱い件数、処理時間、入力トークン、費用を並べます。モデル名だけで決めず、自分の入力で比較することが大切です。
latestと固定版の違い
latestは更新を取り込みやすい一方、将来の変更で結果が変わる可能性があります。業務の再現性を重視するなら特定版を固定し、更新前に同じ検証データで再評価します。
APIとオープンウェイト
pplx-decider v1.2は、PerplexityのAPIで利用する方法に加え、公開された重みを取得して自分の環境で動かす方法があります。標準モデルの公式モデルカードは、Apache-2.0ライセンス、Qwen3.8-27Bを基盤とする約260億パラメータのモデルであることを示しています。テキストと画像を扱い、複数の質問を一つのシーケンスで評価できます。
APIはサーバーの準備を減らせます。認証、モデルの読込、GPU管理をPerplexity側へ任せ、HTTPSリクエストで判定できます。その代わり、入力を外部サービスへ送るため、個人情報や社外秘を扱えるか確認が必要です。保存期間、利用規約、組織の承認を読み、不要な識別情報は送らない設計にします。
オープンウェイトは、環境と運用を自分で管理できますが、無料で簡単という意味ではありません。標準版のモデルカードにはBF16で約52.2GBと記載され、重みに加えて実行用メモリも必要です。Python 3.12以降やCUDA対応GPUなどの条件も示されています。端末へダウンロードできても、安定運用、監視、更新、アクセス制御の費用が発生します。
画像を判定する場合も、画像そのものの権利と個人情報を確認してください。従業員や顧客の顔、位置情報を含む画像、契約で外部送信を禁じられた資料は、技術的に入力できても送ってよいとは限りません。画像の解像度や前処理を変えると結果が変わるため、検証条件も保存します。
料金と必要環境
公式Changelogは、API利用では入力トークン分だけを請求し、Flashはさらに低コストと説明しています。ただし、この記事の確認時点で、Changelog本文だけから日本円の請求額や一件あたりの費用は算出できません。料金表、契約プラン、通貨、入力サイズは変わり得るため、実行直前に公式料金ページとダッシュボードを確認してください。
トークンは文章をAIが処理するための単位です。入力本文が長いほど、質問数が多いほど、画像が大きいほど、必要な処理量は増える可能性があります。公式は一つの入力に最大128問を載せられると案内していますが、上限まで詰めることが最安とは限りません。互いに関係する質問なら共通の入力を再利用できますが、競合する候補を大量に並べると判断が干渉する可能性があります。
当サイトでは、追加の有料APIやクレジットを自動購入しない方針です。そのため今回は実行せず、仕様確認までに留めました。試す場合は、予算上限、一日あたりの件数、失敗時の再試行回数、ログへ残す項目を先に決めます。Perplexity全体の料金やクレジットを調べたい方は、Perplexity Computerの料金とクレジット解説も参考にしてください。
Perplexity Decisions APIの使い方と注意点
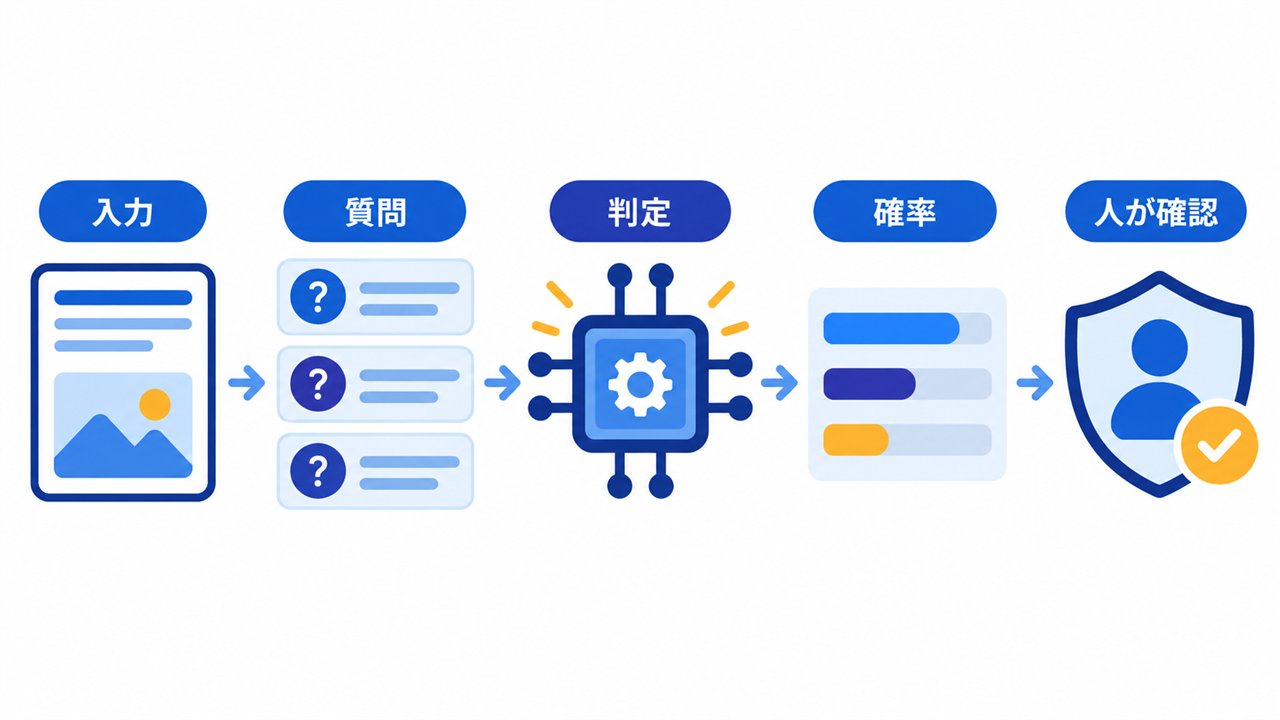
導入は、いきなり本番データへ接続するのではなく、正解が分かっている小さなデータで始めます。入力、質問、選択肢、採用ルールを分けて設計すると、誤ったときにどこを直せばよいか分かります。
リクエストを四つの部品に分ける
APIの入口はPOST https://api.perplexity.ai/v1/decisionsです。AuthorizationヘッダーにBearerトークンを指定し、本文へモデル、状態、質問を入れます。APIキーは公開リポジトリやブラウザ側のJavaScriptへ書かず、サーバーの秘密情報として管理してください。
設計時は、リクエストを次の四つに分けます。
- state:判定する文章や画像。必要な範囲だけに絞る。
- question:何を判断するか。一文で一つの観点にする。
- options/scale:選択肢や点数の意味。重なりを減らす。
- 運用ルール:何%なら自動処理し、どこから人へ回すか。
たとえば問い合わせ分類なら、本文をstateに入れ、「主な問い合わせ種別は何か」と尋ね、営業・請求・技術・その他を候補にします。氏名、メールアドレス、契約番号など、分類に不要な値は置き換えます。件名だけで十分か、本文が必要かも検証し、最小限の情報にします。
複数のことを一つの質問へ詰め込まないことも重要です。「営業案件であり緊急か」を一度に聞くと、営業だが緊急ではない入力の扱いが曖昧になります。カテゴリと緊急度を別の質問へ分ければ、それぞれの確率を独立して確認できます。
APIリファレンスには400、401、413、429などのエラー例があります。入力不備、認証失敗、サイズ超過、リクエスト過多を同じ再試行で扱わないでください。401を何度送っても直りません。429は待ち時間を設け、413は入力を小さくし、400はスキーマを見直します。
確率を業務ルールへつなぐ
応答に確率が含まれても、最上位をそのまま確定結果にする必要はありません。上位二候補の差、最低確信値、重要カテゴリの見逃しを組み合わせて、人へ回す条件を作ります。
仮に「請求」が0.72、「技術」が0.24なら、0.72を十分とするかは業務によります。担当部署へ仮転送するだけなら使えるかもしれませんが、返金を自動実行する根拠には弱いでしょう。誤判定の影響が大きい処理ほど、しきい値を高くし、別の確認を加えます。
おすすめは三段階です。高確信は自動で仮分類、中間は人へ確認、低確信や入力不足は保留にします。人が直した結果を保存すれば、どのカテゴリで迷いやすいか分かります。ただし、利用者の同意や社内ルールなしに個人データを学習用へ再利用しないでください。
| 出力の状態 | 処理例 | 記録するもの |
|---|---|---|
| 高確信かつ低リスク | 仮分類して担当へ提示 | モデル版、入力ID、確率 |
| 中間または上位差が小さい | 人の確認待ち | 候補、修正結果、理由 |
| 低確信・入力不足 | 保留して追加情報を求める | 不足項目、エラー種別 |
確率のしきい値は、見栄えのよい数字ではなく、検証データから決めます。0.8以上なら安全という共通ルールはありません。カテゴリごとの誤判定率と業務損失を比べ、定期的に見直します。
問いをまとめる前に小さく検証する
公式は、一つのAPI入力へ最大128問を含められ、複数問を一度に処理できると案内しています。共通の文章に対して「カテゴリ」「緊急度」「個人情報の有無」を同時に見るなら、入力を繰り返し送らずに済む利点があります。
一方、モデルカードは質問同士の関係に注意を促しています。互いに補い合う観点はまとめやすいですが、同じ候補を競わせる大量の問いは、別々に処理したほうが安定する場合があります。Flashについて公式Changelogは、まず一問での利用を既定として、まとめる場合は自分の作業で検証するよう勧めています。
最初は一問で基準値を作ります。次に関連する二〜三問へ増やし、同じ入力で結果が変わらないか確認します。128問へ一気に広げるのではなく、速度、費用、精度がどの段階で悪化するか測ります。
モデル更新でも同じ検証を繰り返します。latestを使うなら更新日をログへ残し、重要な分類は固定版と並行比較します。予告なしに挙動が変わったように見えても、入力文、質問順、画像処理、しきい値の変更が原因かもしれません。構成を版管理すると切り分けやすくなります。
Perplexityが同日に公開した機能には、アプリの仕組みを調べるComputer用スキルもあります。用途は別なので、ソフト解析を探している場合はPerplexity Reverse Engineerの解説をご覧ください。
精度と公平性を評価する
検証データは、簡単な成功例だけで作らないでください。短文と長文、丁寧な表現と口語、画像ありとなし、空欄、誤字、複数カテゴリにまたがる内容を含めます。実際の利用者に日本語以外の言語があるなら、言語別に評価します。
正解率だけを見ると、件数の少ない重要カテゴリを見落とします。請求が全体の90%、不正利用が1%なら、すべて請求と答えても高い正解率に見える場合があります。不正利用をどれだけ拾えたか、正常な利用を誤って止めていないかを別々に測ります。
人に関する判断では、属性による偏りにも注意が必要です。採用、与信、医療、保険、教育、法的判断など、高い影響を持つ用途でモデルだけに最終決定を任せないでください。入力から不要な属性を外しても、住所や文章表現が代理変数になる可能性があります。法務、セキュリティ、業務責任者を含めて用途を審査します。
説明責任のため、モデル版、質問文、選択肢、しきい値、処理時刻、最終確認者を残します。ただし、ログへAPIキーや全文の個人情報を保存しないでください。必要な監査情報と、保存してはいけない秘密を分けます。
公開後に精度が落ちることもあります。問い合わせ内容や商品構成が変われば、古い検証データは現場を表さなくなります。毎週または毎月、無作為に抽出した結果を人が確認し、カテゴリ別の誤りと保留率を追います。問題が増えたら、自動処理を止めてしきい値か質問文を見直せるようにします。
検証表には、入力ID、正解、モデルの第一候補、確率、人の最終判断を一行ずつ並べます。個人を特定できる本文は検証表へ複製せず、権限を分けた元データとIDで結びます。誤りを見つけたら「モデルが悪い」で終わらせず、選択肢の定義不足、情報不足、画像の見切れ、複数意図の混在など原因を分類してください。質問文を直した場合は、直した例だけでなく以前に正解できた例も再評価します。あるカテゴリを改善した結果、別のカテゴリが悪化することがあるからです。
障害時の動きも本番前に決めます。APIが429や5xxを返したとき、判定できなかった入力を自動で承認してはいけません。短い待機後に回数を限定して再試行し、それでも失敗したら人の確認待ちへ送ります。同じ入力を何度も送ると費用や重複処理が増えるため、リクエストIDと処理状態を保存します。タイムアウト後に結果が不明な場合は、後続処理が実行されたか照合してから再送します。
利用者への案内も忘れないでください。AIが一次分類に使われること、最終判断を人へ申し立てられること、誤りを連絡できる窓口を、用途に応じて分かる形で示します。社内向けでも、担当者が確率を確定事項と誤解しないよう、画面には候補と根拠となる基準、確認が必要な理由を表示します。技術的な精度だけでなく、誤りに気づいて直せる運用まで含めて導入品質です。
◆もっちゃんのワンポイント
最初の目標は「全部自動化」ではなく、「人が見る順番を整える」にすると安全です。確率は判断を置き換える数字ではなく、確認をどこへ集めるか決める手掛かりとして使いましょう。
よくある質問
Q1. 日本語の文章も分類できますか?
A. 公式モデルカードは多言語データを含む評価を掲載していますが、この記事では日本語の実測をしていません。自社の日本語表現、略語、誤字を含む正解データで、モデルごとに確認してください。
Q2. 最大128問は毎回まとめたほうが得ですか?
A. いいえ。関連する観点はまとめやすい一方、質問同士が干渉する可能性があります。一問の結果を基準に、少数ずつ増やして速度・費用・精度を比べます。
Q3. 返された確率が90%なら自動承認できますか?
A. 数値だけでは判断できません。検証データで90%以上のときにどれだけ誤るかを測り、誤判定の影響に合わせて人の確認を残してください。
Q4. APIと自前運用はどちらが安いですか?
A. 件数、入力サイズ、GPU、保守人員、セキュリティ要件で変わります。API料金だけでなく、自前運用の機器、監視、更新、障害対応まで含めて比較してください。
Q5. 個人情報をそのまま送ってもよいですか?
A. 技術的に入力できても、送信してよいとは限りません。利用規約、契約、法令、社内規程を確認し、判定に不要な識別情報は削除または置換してください。
まとめ|Perplexity Decisions APIは小さな分類から試す
Perplexity Decisions APIは、文章や画像へ質問を設定し、分類候補やスコアを確率付きで返す仕組みです。27Bの標準版と4BのFlash版があり、APIとオープンウェイトの両方が案内されています。説明文を解析する手間を減らし、問い合わせの振り分けや基準採点をシステムへ組み込みやすい点が特徴です。
一方、確率は正しさの保証ではありません。質問の境界が曖昧なら結果も揺れ、モデルや質問の更新で挙動が変わる可能性があります。正解が分かる小さなデータで一問ずつ試し、モデル版、質問文、しきい値、人の確認結果を記録してください。
今日できる準備は、実データを送ることではありません。分類したい対象を一つ選び、候補の定義を文章にし、個人情報を除いた20〜50件ほどの検証例と正解を用意することです。その土台があれば、標準版とFlashを同じ条件で比べ、費用を掛ける価値があるか判断できます。
公式情報