【PR】この記事には、アフィリエイトを含む案内があります。
こんにちは。AIあれこれ散歩道、運営者のもっちゃんです。
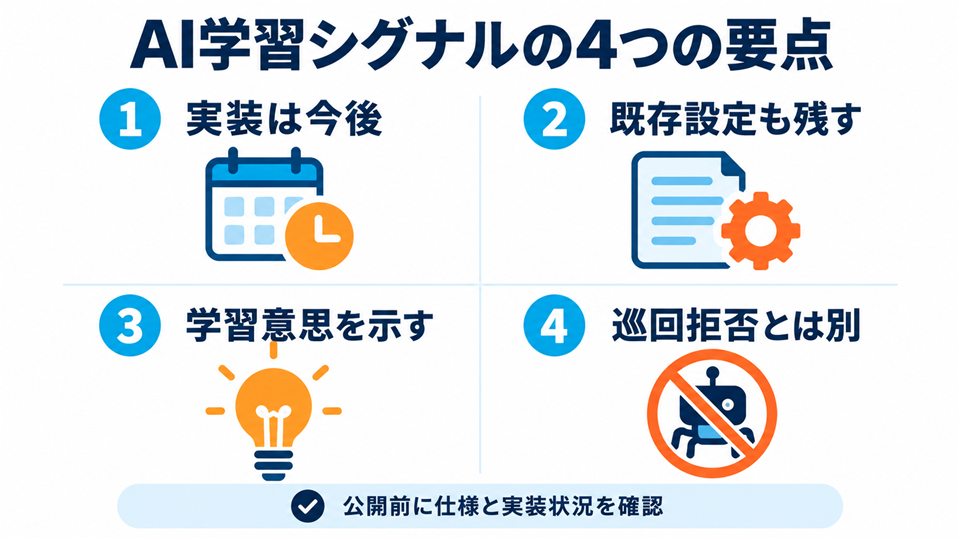
AI学習の共通シグナルは、Webサイト運営者が「公開した内容を生成AIの学習へ使ってよいか」を複数の事業者へ同じ形式で伝えるための提案です。OpenAIは2026年10月30日、この共通シグナルを尊重する方針を発表しました。ただし、発表時点では実装は「今後数か月」を目標とする段階で、今日すぐ既存のrobots.txtを書き換えれば全事業者へ反映される完成済みの標準ではありません。
もう一つ大切なのは、AI学習への意思表示と、クローラーのアクセス許可が別の問題だという点です。新しい提案は学習用途の希望を示すもので、巡回そのものを止める命令ではありません。GPTBotやOAI-SearchBotなど、現在使われている既存の指定も残る予定です。この記事では、発表内容、IETFで公開された草案、既存クローラー指定との違いを分け、サイト運営者が今できる準備を解説します。
- 共通シグナルはAI学習への選好を伝える提案
- OpenAIでの実装は発表時点では今後の予定
- GPTBotや検索用クローラーの既存指定は残る
- 標準化と実装状況を確認してから変更する
AI学習の共通シグナルの仕組み
robots.txtは、サイトのルートに置くテキストファイルです。一般には検索エンジンや各種ボットへ、どの経路を巡回してよいかを伝えるために使われます。今回の提案は、その広く使われている仕組みを利用して、AI学習という「利用目的」についても意思表示できるようにする考え方です。新しい管理画面を各社ごとに開くのではなく、サイト側が一つの形式で希望を示せることに価値があります。
OpenAIが発表した内容と開始時期
OpenAIは、WebサイトがAI学習に関する希望を表明する共通の仕組みを支持し、自社のクローラーで尊重すると発表しました。背景には、サイト運営者が事業者ごとに異なるボット名や設定方法を追い続ける負担があります。共通形式なら、一つの意思表示を複数のAI事業者が読める可能性が生まれます。コンテンツを公開する人が利用条件を理解しやすくするという意味で、重要な前進です。
一方、発表文は「今後数か月で実装することを目指す」という将来形です。つまり、公開日からすべてのOpenAIクローラーが新しい指定を解釈していると断定してはいけません。実際の開始日、対象クローラー、既存指定と競合した場合の優先順位、ログで確認する方法などは、今後の公式更新を待つ部分があります。速報を読んで設定例だけを先にコピーするより、実装済みかを確認する方が安全です。
発表された方針と、現在運用されている機能を分けて読む癖をつけましょう。運用担当者は発表URLと確認日を記録し、月に一度など決めた間隔で公式クローラー資料と草案を確認します。変更が公開されたら、まず検証用サイトや影響の小さい経路で試し、アクセスログと表示状態を見てから本番全体へ広げる流れが現実的です。
robots.txtの草案で提案された書き方
IETFのDatatrackerで公開されたInternet-Draftでは、AI学習用途を表す仮想的な利用者名として「__usage_ai-training」を使い、AllowやDisallowで経路ごとの希望を示す方法が提案されています。考え方としては、サイト全体を学習対象にしない、公開記事は許可するが会員向け経路は対象外にする、といった粒度を想定できます。
User-Agent: __usage_ai-training
Disallow: /
上の例は草案の考え方を理解するためのものです。現時点で本番へそのまま追加すれば目的を達成できると保証する手順ではありません。Internet-Draftは議論と実装検討のために公開される作業文書であり、承認済みRFCと同じではありません。内容は更新、置換、失効する可能性があります。番号、版、更新日を見ずに古い例を固定化すると、後の仕様と食い違うことがあります。
草案では、利用目的への選好とアクセス制御を直交するものとして扱います。言い換えると、学習へ使わないでほしいという希望を示しても、ボットがページを取得できないとは限りません。検索結果の生成、リンク確認、安全対策など、学習以外の目的で取得される可能性もあります。アクセス自体を制限したい場合は、対象クローラー、認証、公開範囲など別の管理を検討する必要があります。
GPTBotとOAI-SearchBotは役割が違う
OpenAIの公式クローラー資料では、GPTBotとOAI-SearchBotが別に説明されています。GPTBotは生成AIモデルの改善に関係するクローラーです。OAI-SearchBotはChatGPTの検索機能でWebページを見つけ、回答へリンクするためのクローラーです。片方への指定が自動でもう片方へ適用されると考えず、目的ごとに確認する必要があります。
たとえば、検索から記事へ訪問してほしいが、モデル改善への利用は望まないという運営方針があります。その場合は、検索用クローラーを許可し、学習用クローラーへの希望を別に示す設計が必要です。逆に、会員限定の情報や個人情報は、ボット指定だけに頼らず認証で守るべきです。robots.txtは公開状態のファイルで、秘密情報を隠す仕組みではありません。
ChatGPT-Userのように、利用者の操作に応じてページへアクセスする主体もあります。自動巡回、検索、利用者の明示操作を同じものとして扱うと、意図しない表示低下や機能停止につながります。公式資料のボット名、目的、設定例、更新日を表にし、自サイトの希望と一対一で対応させると判断しやすくなります。
共通化で解決できることと残る課題
共通化の利点は、運営者の意思表示を分かりやすくすることです。現在はAI事業者ごとにボット名、文書、管理方法が異なり、追加や変更を追う必要があります。共通シグナルが広く採用されれば、CMSやホスティングサービスが分かりやすい設定画面を提供し、小規模サイトでも方針を示しやすくなる可能性があります。
ただし、シグナルは技術的な意思表示であり、契約、著作権、利用規約、法的判断を一つで解決するものではありません。誰がシグナルを尊重しているか、過去に取得されたデータへどう扱われるか、派生データや検索インデックスが対象かなど、事業者の説明が必要です。また、悪意あるボットが設定に従う保証もありません。
注意: robots.txtへ書けば非公開になるわけではありません。公開したくない情報は、認証、権限、保存場所、配信設定で守ってください。
AI学習の共通シグナルを設定する前の確認
サイト運営者が今すぐ行うべきことは、未実装の例を急いで追加することではなく、自分の方針と現状を把握することです。検索流入を維持したいのか、学習用途だけを拒否したいのか、全文転載のような別の問題を心配しているのかで、必要な対応は変わります。技術設定の前に、対象と目的を書き出しましょう。
最初に自サイトの目的と公開範囲を決める
まず、サイト内のコンテンツを種類ごとに分けます。一般公開の記事、商品ページ、FAQ、投稿フォーム、会員ページ、社内資料、個人情報を含む経路では扱いが異なります。一般公開の記事は検索へ載せたい一方、会員ページはクローラーに関係なく認証が必要です。投稿フォームの確認画面や管理画面は、robots.txtよりアクセス制御を優先します。
次に、AI利用について「許可」「拒否」「未決定」を整理します。すべてを一括で決める必要はありません。著者や契約によって権利条件が異なるなら、経路を分ける、公開前の同意を見直す、利用規約へ方針を明記するなど、運用から整えます。技術担当だけで決めず、編集、法務、事業責任者が同じ表を見られる状態が理想です。
- 検索表示を維持したいページ
- AI学習への希望を示したいページ
- 認証で非公開にするページ
- 契約や著者確認が必要なページ
変更前に保存と検証手順を用意する
robots.txtは短いファイルですが、誤った指定は検索クローラーの巡回へ影響する可能性があります。変更前の全文、更新日時、担当者、変更理由、期待する結果、元へ戻す手順を保存してください。CMSやSEOプラグインが自動生成している場合は、手動編集が上書きされないかも確認します。キャッシュやCDNが古い内容を返すケースもあります。
検証では、公開URLからrobots.txtを取得し、HTTP状態、文字コード、内容を確認します。次に、対象ボットの公式資料にあるテスターや検索エンジンの検査機能が利用できる場合は、代表URLで試します。アクセスログで該当User-Agentの変化を観測し、検索表示、参照流入、インデックス状況を一定期間比較します。反映には時間差があり得るため、変更直後の一回だけで結論を出しません。
今回の共通シグナルについては、実装開始の公式告知と最終的な書式が確認できるまで、草案例を本番手順として扱わない判断も立派な対応です。待つ場合も、確認日と次回確認日を決めれば放置ではありません。速報を見た日、OpenAIのクローラー資料、Internet-Draftの版を記録しておけば、変更点を比較しやすくなります。
検索流入とAI学習を別々に観測する
設定後の評価では、検索流入が減ったかどうかだけでAI学習の拒否が成功したと判断できません。検索クローラーと学習クローラーは目的が違い、アクセスログのUser-Agentも別です。検索順位、表示回数、クリック、クローラーアクセス、サーバー負荷を分けて記録します。取得できない指標は推測で埋めず、未取得と明記します。
AIサービスの回答に自サイトの内容が現れるかを観測する場合も注意が必要です。回答に似た表現が出たことだけで、新しい学習利用を断定できません。検索結果の参照、過去データ、他サイトの引用など複数の可能性があります。出典リンク、回答日時、利用モデル、検索の有無、再現条件を残し、事業者の公式説明と合わせて判断します。
変更後は7日を早期確認、14日と28日を評価日など、あらかじめ観測期間を決めると過剰反応を防げます。重大な不具合がなければ、観測中に同じURLの設定を何度も変えません。変数を一つにし、変更前の基準と比較することで、何が影響したかを追いやすくなります。
よくある質問
運用方針を文書にするときは、技術用語だけで終わらせず、読者や著者にも分かる言葉を使います。「当サイトは一般検索への掲載を希望します」「生成AIモデルの学習利用については、公式の共通シグナルが実装された後に経路ごとに意思表示します」「会員向け情報は認証で保護します」のように、目的と手段を分けて書きます。これにより、robots.txtの一行だけを見て運営方針を推測する必要がなくなります。
複数の著者や外部提供コンテンツを扱うサイトでは、掲載契約も確認してください。サイト運営者が一括してAI学習の可否を決められるとは限りません。著者ごとに希望が違う場合は、コンテンツを別の経路へ置く、契約更新時に利用目的を確認する、過去記事は現状を維持して新規記事から選択肢を設けるなど、実行できる単位へ分けます。技術設定より先に権利関係を揃えると、後の変更がぶれにくくなります。
WordPressでは、robots.txtが実ファイルではなく動的に生成されている場合があります。テーマ、SEOプラグイン、ホスティング、CDNのどこが内容を管理しているかを確認し、同じ設定を二重に書かないようにします。ステージング環境でDisallowを使っている場合は、その設定を本番へ持ち込まないことも重要です。更新作業のチェックリストへ「公開URLからrobots.txtを読み戻す」を入れておくと、管理画面上の表示だけで成功と判断するミスを減らせます。
アクセスログを確認するときは、User-Agentの文字列だけで正規のクローラーだと断定しないでください。文字列は第三者でも名乗れます。公式資料がIP範囲や検証方法を案内している場合は、それに従います。ログへ個人情報や認証情報が含まれる環境では、共有範囲と保存期間も決めます。目的はクローラーの傾向を知ることであり、必要以上に長くすべてのアクセス情報を保管することではありません。
検索順位への影響を心配する場合は、検索用クローラーを誤って拒否していないかを最初に確認します。AI学習を拒否したいという目的から、すべてのボットへ一括でDisallowを置くと、検索結果に必要な巡回まで止めるおそれがあります。変更案は差分でレビューし、対象User-Agentと経路を声に出して説明できる状態にします。説明できない指定は本番へ入れず、公式例へ戻ってください。
小規模サイトでも、最低限の変更台帳は役立ちます。表計算やテキストで、確認日、公式資料のURL、草案の版、現在のrobots.txt、変更者、仮説、観測項目、復元元を一行にまとめます。14日後と28日後に、検索表示回数、クリック、クローラーアクセス、問い合わせなど取得できた事実だけを追記します。変化がなければ「変化なし」、測れなければ「null」と書き、成功したように見せるための推測は入れません。
共通シグナルが広まれば、事業者ごとの設定負担は減る可能性がありますが、採用時期はそろわないと考えておく方が現実的です。ある事業者は早く対応し、別の事業者は検討中という期間が生まれます。その間は、共通シグナルと既存ボット指定を併記する可能性があります。どちらを優先するかは自己判断で決めず、各事業者の公式移行案内を確認します。
実装が始まった後も、設定した事実と、事業者が尊重した結果は別に記録します。robots.txtがHTTP 200で取得でき、書式が正しくても、相手側の反映に時間がかかる場合があります。反対に、ログへアクセスが残っていても、それだけで学習へ利用されたとは断定できません。取得、検索、学習という異なる段階を混ぜず、確認できる範囲を明示することが、誤解の少ない説明につながります。
読者から問い合わせを受ける窓口も用意すると安心です。著者が自分の記事の扱いを確認したい、企業が引用や学習方針を知りたい、設定変更後に検索表示が変わったという連絡が来たとき、担当者と回答の根拠が分かるようにします。回答では法的な断定を避け、現在の技術設定、確認日、参照した公式文書、未確認事項を分けて伝えます。
最終的には、公開コンテンツの価値を届けることと、望まない利用を減らすことの両方を考えます。検索、SNS、ニュースレター、直接訪問など流入経路を分散し、特定のクローラー変更だけで読者との接点が失われないようにします。技術仕様は変わるため、設定を一度決めて終わりにせず、公式更新と自サイトの成果を定期的に見直してください。
社内でレビューするときは、設定案を「現状」「変更案」「期待する効果」「起こり得る副作用」の四列で比較します。現状のrobots.txt全文を左に残し、追加する行だけ色を付けると、検索用クローラーへ意図せず影響する変更を見つけやすくなります。レビュー担当者は、AI学習を制御したいという目的と、実際に選んだUser-Agentが一致しているかを確認します。承認後も差分と承認日時を保存し、口頭だけで変更しません。
外部の設定生成ツールや記事を利用する場合は、最終更新日と根拠URLを確認します。古い記事には、現在使われていないボット名や、検索と学習を混同した例が残ることがあります。生成された内容をそのまま貼らず、各行が誰へ何を伝えるか説明できるかを確かめます。分からない行は削るのではなく、公式資料で意味を確認してから採否を決めます。
多言語サイトや複数ドメインを運営している場合、ルートごとにrobots.txtが必要です。日本語サイトの設定を英語サイトへ自動で反映できるとは限らず、サブドメインも別に確認します。コンテンツ配信ネットワークや画像専用ドメインがある場合は、どこに元コンテンツがあり、どのURLが正規ページかを整理します。サイトマップとcanonicalの状態も合わせて確認すると、検索への影響を切り分けやすくなります。
新しい共通シグナルが正式に実装された際は、この記事のような解説も更新が必要です。実装日、対応事業者、確定した書式、既存指定との優先順位を追加し、将来予定と書いた部分を実測結果へ置き換えます。更新履歴に何を確認したかを残し、古いコード例が検索結果へ残り続けないようにします。読者側も、設定前に記事の確認日と公式リンクを見てください。
判断に迷う場合は、何もしない期間にも期限を設けます。「公式実装の案内が出るまで保留し、毎月第一営業日に確認する」のように決めれば、未確認のまま放置する状態を避けられます。保留中は既存のGPTBotや検索用クローラー設定を維持し、設定ファイルを不用意に簡略化しません。新しい情報が出たら、差分、対象、反映日を確認してから次の行動を決めます。
AI学習の共通シグナルは、もうOpenAIで使えますか?
2026年10月30日の発表では今後数か月での実装を目指すとされています。実装済みと断定せず、公式クローラー資料の更新を確認してください。
GPTBotを拒否していれば、新しい設定は不要ですか?
既存のGPTBot指定は引き続き尊重される予定です。共通シグナルが実装された後も、対象、優先順位、運用方針を公式資料で確認してください。
学習を拒否すると検索にも表示されなくなりますか?
必ずしもそうではありません。学習用と検索用のクローラーは別に説明されており、設定も独立して確認する必要があります。
robots.txtへ書けばページを非公開にできますか?
できません。非公開情報は認証やアクセス権で守ります。robots.txtは秘密を隠す仕組みではありません。
Internet-Draftは正式な国際標準ですか?
現段階では作業中の提案です。IETFの承認済みRFCではなく、内容が更新、置換、失効する可能性があります。
AI学習の共通シグナルのまとめ
AI学習の共通シグナルは、サイト運営者の意思表示を分かりやすくする有望な提案です。OpenAIが支持を表明したことで実装へ進む可能性は高まりましたが、発表時点では将来の予定であり、完成済みの共通設定ではありません。GPTBot、OAI-SearchBot、利用者操作によるアクセスを分け、既存指定を急に削除しないことが大切です。
- 発表と実装開始を分けて確認する
- 学習への希望と巡回拒否を混同しない
- Internet-Draftを確定仕様として扱わない
- 変更前の保存、検証、観測日を決める
今は、自サイトの公開範囲とAI利用方針を整理し、公式資料の更新を追える状態を作る時期です。実装が確認できたら、小さく検証し、検索と学習を別々に観測してください。
どのAIサービスが自分の用途に合うか迷う方へ
文章作成、画像生成、調査など目的別の選び方は、AIあれこれ散歩道のAIサービス比較でも確認できます。
※一部の外部リンクにはアフィリエイトを含む場合があります。