こんにちは。AIあれこれ散歩道、運営者のもっちゃんです。
ChatGPTで作った文章には、コピーすると見つかる「見えない文字」が入っているのでしょうか。2026年10月5日、OpenAIは文章向けの透かし技術「textGrain」を発表しました。ただし、日本のChatGPTで今すぐすべての回答に入る、先生や会社が誰でも判定できる、という話ではありません。
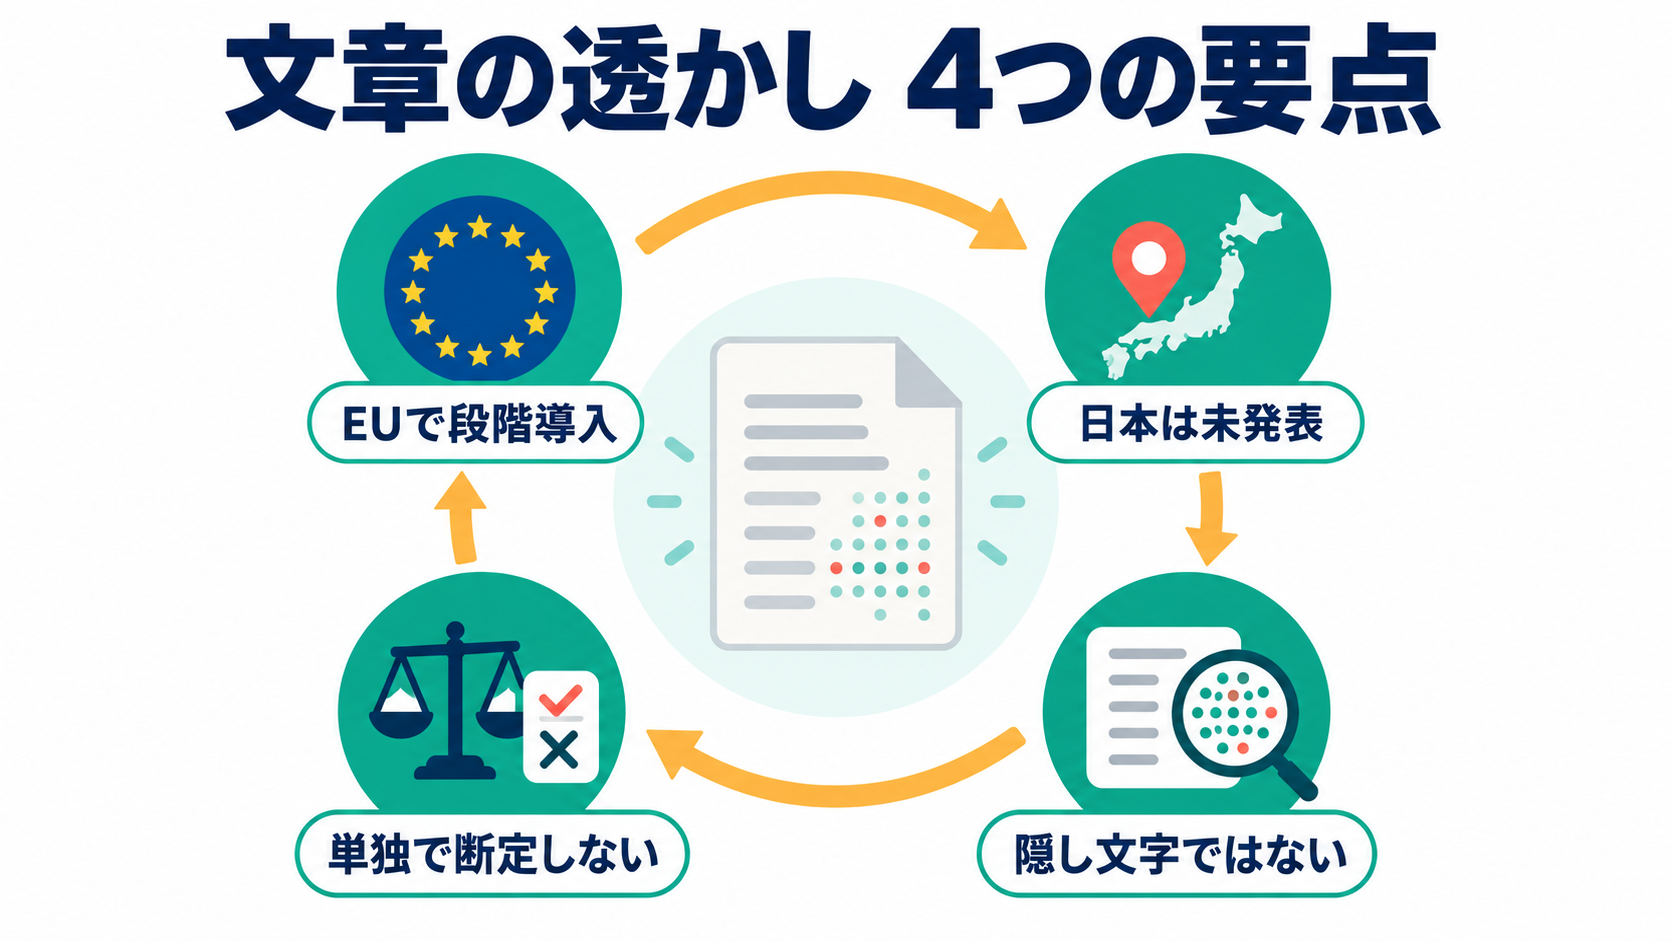
先に結論をまとめると、発表時点で既定導入が案内されているのはEUの対象ChatGPT・Codex文章です。日本のChatGPTへの既定導入日は未発表で、世界のAPI利用者は対応モデルを選んで有効化する方式です。しかも、文章用の検出器は一般公開されていません。この記事では、地域と製品を分けながら、何が分かり、何を断定できないのかを整理します。
- textGrainが隠し文字ではない理由
- EUと日本で異なる導入状況
- 一般の人が今できる確認
- 学校や仕事で誤判定を防ぐ考え方
先に結論:2026年10月6日確認時点では、EUの対象ChatGPT・Codex文章へ今後数週間でtextGrainを導入する予定です。日本のChatGPTへの既定導入は発表されておらず、一般利用者が文章を貼り付けて判定できる公式検出器もありません。透かしの有無だけで、著者、不正利用、文章の正しさを決めつけないことが大切です。
ChatGPTの透かしは日本で入る?
この疑問に答えるには、「どの地域で」「どの製品を使い」「いつ作られた文章か」を分ける必要があります。OpenAIの発表は、ChatGPT全世界へ一斉に同じ仕組みを入れるという内容ではありません。
2026年10月5日に発表されたtextGrain
OpenAIは2026年10月5日、EUの文章来歴ルールへの対応として、独自の文章透かし技術textGrainを公表しました。来歴とは、コンテンツがどこから来たのかを確かめるための手がかりです。画像で使われる撮影情報やContent Credentialsに近い目的ですが、文章では画像と同じ方法をそのまま使えません。
OpenAIの公式発表によると、textGrainはモデルが文章を生成するときの「次にどの言葉を選ぶか」という確率へ、ごく小さな統計的な偏りを加えます。対応する検出器は長い文章の中にそのパターンが見えるかを調べます。読者の画面に記号や帯が表示されるわけではありません。
今回の発表には三つの動きがあります。EUの対象ChatGPT・Codex文章への段階導入、世界のAPI利用者向けの選択式設定、そして研究者・専門組織向けの検出器申請です。三つを混ぜると「日本でも自動で入る」「誰でも検出できる」と誤解しやすくなります。
隠し文字や不可視スペースではない
「透かし」という言葉から、文章の末尾に見えない記号が付く、コピーすると特殊な空白が見つかる、と想像するかもしれません。しかし、OpenAIの公式ヘルプは、textGrainが隠し文字、不可視スペース、特殊な句読点、透かし専用のトークンを追加する仕組みではないと説明しています。
たとえば「重要です」と「大切です」のどちらも自然に続けられる場面で、モデルには複数の言い方があります。textGrainは、その候補の選ばれ方に鍵と対応したパターンを作ります。一つの単語だけを見ても分からず、ある程度の長さを持つ文章全体で統計的に確かめる考え方です。
そのため、ブラウザの「書式をクリア」やメモ帳への貼り付けで、透かし用の文字を消すという説明は当てはまりません。反対に、見た目が普通だから「透かしはない」とも判断できません。人が目で探すものではなく、対応する設定と鍵を持つ検出器が調べる信号だからです。
EU・日本・APIで状況が違う
OpenAIは、EUの対象となるChatGPTとCodexの文章へ、発表日から今後数週間をかけて全プランで導入すると案内しています。一方、開始時点では世界共通の既定機能にしないとも明記しています。日本の個人向けChatGPTにいつ既定導入するかは、2026年10月6日確認時点で発表されていません。
| 利用場面 | 発表時点の扱い | 注意点 |
|---|---|---|
| EUのChatGPT・Codex | 対象文章へ今後数週間で段階導入 | 正確な開始日と対象範囲は今後の案内を確認 |
| 日本のChatGPT | 既定導入は未発表 | EUの説明を日本へそのまま当てはめない |
| 世界のOpenAI API | 対応モデルを選び、利用者側がopt-in | 既定off。対応モデルは設定画面で確認 |
| 文章の検出 | 承認された研究者・専門組織へ限定提供 | 一般公開の貼り付け判定ツールではない |
API利用者向けには、プロジェクト設定または組織設定のText provenanceから、対応モデルへの透かしを有効にする流れが案内されています。これは日本の企業でも利用可能になる可能性がありますが、「APIで選べる」ことと「日本のChatGPTで自動的に入る」ことは別です。会社がAPIで独自サービスを作っている場合は、管理者へ設定状況を確認してください。
また、OpenAIは対応モデルの一覧を固定した文章ではなく、設定画面で確認するよう案内しています。モデル名や対象範囲は更新される可能性があるため、古いスクリーンショットや第三者の記事だけで判断しない方が安全です。
短い回答やコードは判定しにくい
文章の統計的なパターンを確かめるには、ある程度の長さと、言い換えの選択肢が必要です。短い回答では材料が少なく、計算問題や定型文のように答え方が限られる文章でも信号を作りにくくなります。コードは文法や関数名に制約が多く、自然文ほど自由に単語を選べません。
公式ヘルプでは、EUの透明性行動規範が200トークン未満の出力とコード片を透かし要件の対象外としていることも説明されています。ただし、これは「Codexが出すすべての文章とコードに絶対入らない」と言い換えられる情報ではありません。Codexには自然言語の説明も含まれ、eligible outputの厳密な範囲は発表文だけでは分かりません。
学校の短い回答、メールの一文、数行のコードを見て、公式textGrainで機械的に白黒をつけられると期待しないでください。短い文章に対する判定の難しさは、AIを使った事実とも、人が書いた事実とも同じではありません。
編集や翻訳で信号が弱くなることがある
textGrainは文字列にタグを付ける方式ではなく、言葉の選び方へ信号を入れます。そのため、文章をほぼそのままコピーした場合は信号が残る可能性がありますが、大きく書き換えたり、別の言語へ翻訳したりすると検出しにくくなります。
OpenAIは、一般的な軽い編集に耐えることを目指す一方、強い言い換えや翻訳で透かしが検出不能になる可能性を明記しています。これは「こうすれば消せる」という回避方法を勧める話ではなく、検出できなかった結果にも限界があるという意味です。
反対に、検出された場合でも、その文章のすべてをAIが作ったとは限りません。人が下書きを作り、AIに一部だけ直してもらった可能性もあります。透かしはOpenAIモデルの関与を示す手がかりであり、人がどこまで考え、どこを編集したかまで測るものではありません。
ChatGPTの透かしをどう確認する?
結論から言うと、現在の日本の一般利用者が、文章を公式サイトへ貼り付けてtextGrainを検査する方法はありません。画像・音声の確認機能と、文章用の検出器を混同しないことが最初のポイントです。
文章の公式検出器は一般公開されていない
OpenAIのverifyページとContent Provenance APIは、対応する画像や音声の来歴信号を確認できます。しかし、開発者向け公式文書では、文章の検証は承認された研究機関や専門組織に限ると書かれています。画像を検査できるからといって、文章も同じ画面で判定できるわけではありません。
OpenAIが一般公開を急がない理由の一つは、誤判定の影響です。信号があるのに見逃す偽陰性と、信号がない文章をあると判定する偽陽性の両方が起こり得ます。検出結果の意味を理解せず、試験や採用の決定へそのまま使うと、人を不当に疑う危険があります。
注意:第三者の「AI文章判定ツール」が、OpenAIのtextGrain検出器とは限りません。一般的なAI検出器は文章の癖を分類していることが多く、秘密鍵に対応する公式信号を読む仕組みとは別です。サービス名と判定方式を確認し、結果だけで処分や評価を決めないでください。
検出結果だけで著者や不正は分からない
仮に将来、正式な検出結果を得られても、それだけでは著者、所有者、利用目的、文章の正しさは分かりません。OpenAIのヘルプも、来歴信号は正確性、未編集であること、法的な所有、正しい文脈を保証しないと説明しています。
たとえば、社員が自分で作った議事録をChatGPTで読みやすく整えた場合、AIの関与を示す信号が残るかもしれません。しかし、会議内容を考えた人、事実確認した人、最終責任を持つ人まで透かしから読み取れるわけではありません。学生が自分の論点を作り、表現だけ支援してもらった場合も、授業の利用ルールに沿うかは別の確認が必要です。
反対に、信号が見つからない文章も、人が一から書いた証明にはなりません。対応前に作られた、対象外の製品やモデルを使った、短すぎた、大きく編集された、他社のAIを使った、といった可能性が残ります。「検出なし=人間」「検出あり=不正」という二択にしないでください。
学校や職場では作成過程を合わせて見る
学校でAI利用を確認するなら、完成した文章の判定だけでなく、課題の指示、メモ、資料、下書き、修正履歴、口頭説明を合わせて見ます。本人が論点を説明できるか、引用元を示せるか、数字や固有名詞を確認したかは、透かしより学習過程に近い情報です。
職場では、AI利用を一律に隠す・禁止する前に、どの作業で使ってよいかを決めておく方が実用的です。公開前の事実確認、個人情報の入力禁止、承認者の明記、生成物の保存範囲などを決めれば、透かしの有無だけに頼らず品質を管理できます。
採用課題やコンテストのようにAI利用条件が重要な場面では、開始前に「利用可」「一部可」「不可」を具体的に示し、提出時に使用箇所と確認方法を申告してもらいます。後から検出器だけでルール違反を推定するより、参加者にも審査側にも分かりやすくなります。
受け取った文章を確認する5つの順序
一般向け検出器がない現在でも、文章を安全に扱うためにできることはあります。目的はAIを当てることではなく、文章を信頼して使える状態へ近づけることです。
- 出典を確認する:URL、資料名、発表日、引用箇所が実在するかを見る
- 重要な事実を一次情報へ戻す:料金、法律、日付、仕様、医療・金融などは公式情報と照合する
- 作成過程を聞く:目的、調査方法、AIを使った範囲、人が直した範囲を確認する
- 文章の中身を評価する:論理の飛躍、矛盾、古い情報、存在しない引用を探す
- 用途に応じて人が承認する:公開、契約、評価、処分など影響の大きい判断は担当者が責任を持つ
この順番なら、透かしがあるか分からない文章にも使えます。人が書いた文章にも誤りはあり、AI文章にも正しい内容はあります。来歴と品質を別々に確認するのが大切です。
特に「AIらしい言い回しがある」「箇条書きが多い」「丁寧すぎる」という印象は証拠になりません。日本語では文章の型が似やすく、編集者が整えた文章も同じ特徴を持ちます。違和感は確認のきっかけにとどめ、断定には使わないでください。
作成者が今から残せる記録
自分がChatGPTを使って文章を作る側なら、完成文だけでなく、判断の過程を残しておくと説明しやすくなります。最初のメモ、参照した一次情報、構成案、自分で直した箇所、確認日を保存してください。秘密情報や個人情報をプロンプト履歴へ残す必要はありません。
仕事では、文書の末尾や管理台帳に「AIでたたき台を作成し、担当者が一次情報を確認」「翻訳補助に利用し、固有名詞は人が照合」のように、実際の使い方を短く記録できます。透かしは機械向けの信号ですが、この説明は読む人へ直接伝わります。
学校では、先生の指示に従い、AIへ尋ねた内容、採用しなかった案、自分で追加した考えを提出できる形にします。最終文だけを見せるより、自分が学んだ内容を説明しやすくなります。ルールが分からない場合は、提出後ではなく作業前に確認しましょう。
APIを管理する企業は、Text provenanceを有効にするかを法務・セキュリティ・製品担当で検討し、対応モデルと対象環境を記録します。有効化した場合も、利用者への説明や表示が不要になるとは限りません。OpenAIも、機械可読の来歴信号は必要な目に見える表示の代わりではないと案内しています。
よくある誤解を整理する
一つ目の誤解は、「文章をメモ帳へ貼り付ければ透かしが消える」です。textGrainは書式や特殊文字ではないため、単純な書式削除の話ではありません。二つ目は、「画像のverifyページで文章も調べられる」です。公開中のverify機能は対応する画像と音声が中心で、文章検出は別の限定提供です。
三つ目は、「日本でChatGPTを使った文章はすべて対象」です。発表時点の既定導入はEU onlyで、日本への拡大日は未発表です。ただし、日本企業がAPI設定で選ぶケースは別にあり得ます。地域だけでなく、ChatGPTなのかAPIなのかを確かめてください。
四つ目は、「透かしが見つかれば全部AI作成」です。検出は関与の手がかりであり、人の寄与率を測りません。五つ目は、「見つからなければAI未使用」です。短文、対象外モデル、古い出力、編集、翻訳、他社AIなど複数の可能性が残ります。
今後の更新で確認したいポイント
textGrainは発表されたばかりで、これから変わる情報があります。まず確認したいのは、EUで実際に導入が始まった日と、対象になるChatGPT・Codexの出力です。「今後数週間」という案内だけから特定の日付を推測せず、OpenAIの発表と公式ヘルプの更新日を見てください。
次に、APIの対応モデルです。管理画面で選べるモデルは変わる可能性があり、古い一覧を保存しても現在の契約やプロジェクトへそのまま当てはまりません。組織全体の既定設定と、個別プロジェクトの上書き設定も分けて確認します。あるプロジェクトで有効だから、別のプロジェクトでも有効とは限りません。
三つ目は、文章検出器へのアクセスです。現在は研究・学術などの適格な用途を持つ組織が申請し、個別審査を受ける形です。今後対象が広がる可能性はありますが、申請できることと利用が承認されることは別です。学校や企業が独自判断で「公式検出済み」と表示する前に、使ったツールと権限を確認する必要があります。
四つ目は、言語ごとの性能です。公式ヘルプは、24のEU公用語で検出率に差があったと説明しています。日本語の一般向け性能は今回の発表から確認できません。英語やEU言語の評価グラフを、そのまま日本語文章の精度として紹介しないでください。
五つ目は、法的な表示との関係です。機械が読める信号が入っても、広告、報道、学校、社内文書などで求められる目に見える説明が自動的に不要になるわけではありません。OpenAIも、透かしやContent Credentialsは、必要な表示や注意書きの代わりではないとしています。実際の義務は地域、用途、契約によって変わるため、影響の大きい利用では担当部署や専門家へ確認してください。
更新情報を追うときは、SNSの短い投稿だけで判断せず、公式発表、公式ヘルプ、開発者向け文書の順に照合します。発表日は同じでも、ヘルプだけが後から更新される場合があります。この記事でも公開後に公式情報が変わった場合は、確認日と変更点を分けて更新します。
文章の来歴に関するよくある質問
最後に、今回の発表で迷いやすい点を短くまとめます。
ChatGPT文章の透かしに関するFAQ
Q1. 日本のChatGPT文章にも、今すぐ透かしが入りますか?
A. 2026年10月6日確認時点で、日本のChatGPTへの既定導入日は発表されていません。OpenAIが案内しているのは、EUの対象ChatGPT・Codex文章への今後数週間の段階導入と、世界のAPI利用者向けの選択式設定です。
Q2. コピーや書式削除でtextGrainは消えますか?
A. textGrainは隠し文字や書式ではなく、言葉の選び方に作る統計的信号です。単純なコピーや書式削除を「透かし削除」と考えるのは適切ではありません。一方、大きな言い換えや翻訳では信号が弱まり、検出できないことがあります。
Q3. 先生や会社は誰でも公式に判定できますか?
A. 現時点では、文章用の公式検出器は承認された研究者や専門組織に限られ、一般利用者向けには公開されていません。第三者のAI判定ツールはtextGrain検出器と同じとは限りません。
Q4. 透かしが検出されたら、AIが全部書いた証拠ですか?
A. いいえ。OpenAIモデルが文章の生成や処理に関わった手がかりにはなりますが、文章のどの部分をAIが作ったか、人がどれだけ編集したか、誰が著者か、不正利用かまでは分かりません。
Q5. 透かしが検出されなければ、人が書いた文章ですか?
A. 断定できません。短すぎる文章、対象外の製品・モデル、導入前の出力、大きく編集・翻訳された文章、他社AIの文章などではOpenAIの信号が見つからない可能性があります。出典と作成過程も合わせて確認してください。
ChatGPTの透かしを正しく理解する
OpenAIのtextGrainは、文章に隠し文字を埋める仕組みではなく、モデルの言葉選びへ統計的な信号を加える技術です。2026年10月5日の発表では、EUの対象ChatGPT・Codex文章へ今後数週間で導入し、世界のAPIでは対応モデルを利用者が選んで有効化すると説明されています。日本のChatGPTへの既定導入は未発表です。
一般向けの文章検出器がない現在、読者がやるべきことは「AIか人か」を見た目で当てることではありません。出典を確認し、重要な事実を一次情報へ戻し、作成過程と人の確認範囲を確かめることです。将来検出器を使える場面が増えても、検出結果だけで著者や不正、正確性を決めない姿勢は変わりません。
まずは、自分が文章を受け取る側なら、重要な数字と出典を一つずつ確認してください。作る側なら、AIを使った範囲と人が確認した内容を短く残しましょう。透かしを怖がるより、来歴と品質を分けて管理することが、学校でも仕事でも役立つ次の一歩です。
公式情報が更新されたときも、「日本で使えるようになったか」「一般向け検出器が公開されたか」「対象モデルが変わったか」を別々に確認すれば、見出しだけに振り回されず判断できます。