こんにちは。AIあれこれ散歩道、運営者のもっちゃんです。
OpenAIは2026年11月4日、開発者向け企業Pierreを買収する契約を結んだと発表しました。Pierreは、コードを保存するサービス「Code Storage」と、Gitを扱うためのオープンソース部品「Trees」「Diffs」を手がけています。すでにCodexはTreesとDiffsを利用しているため、今回の発表は単なる企業買収ではありません。複数のAIエージェントが同じ開発作業を並行して進める時代に合わせ、ソース管理そのものを作り直そうとする動きです。
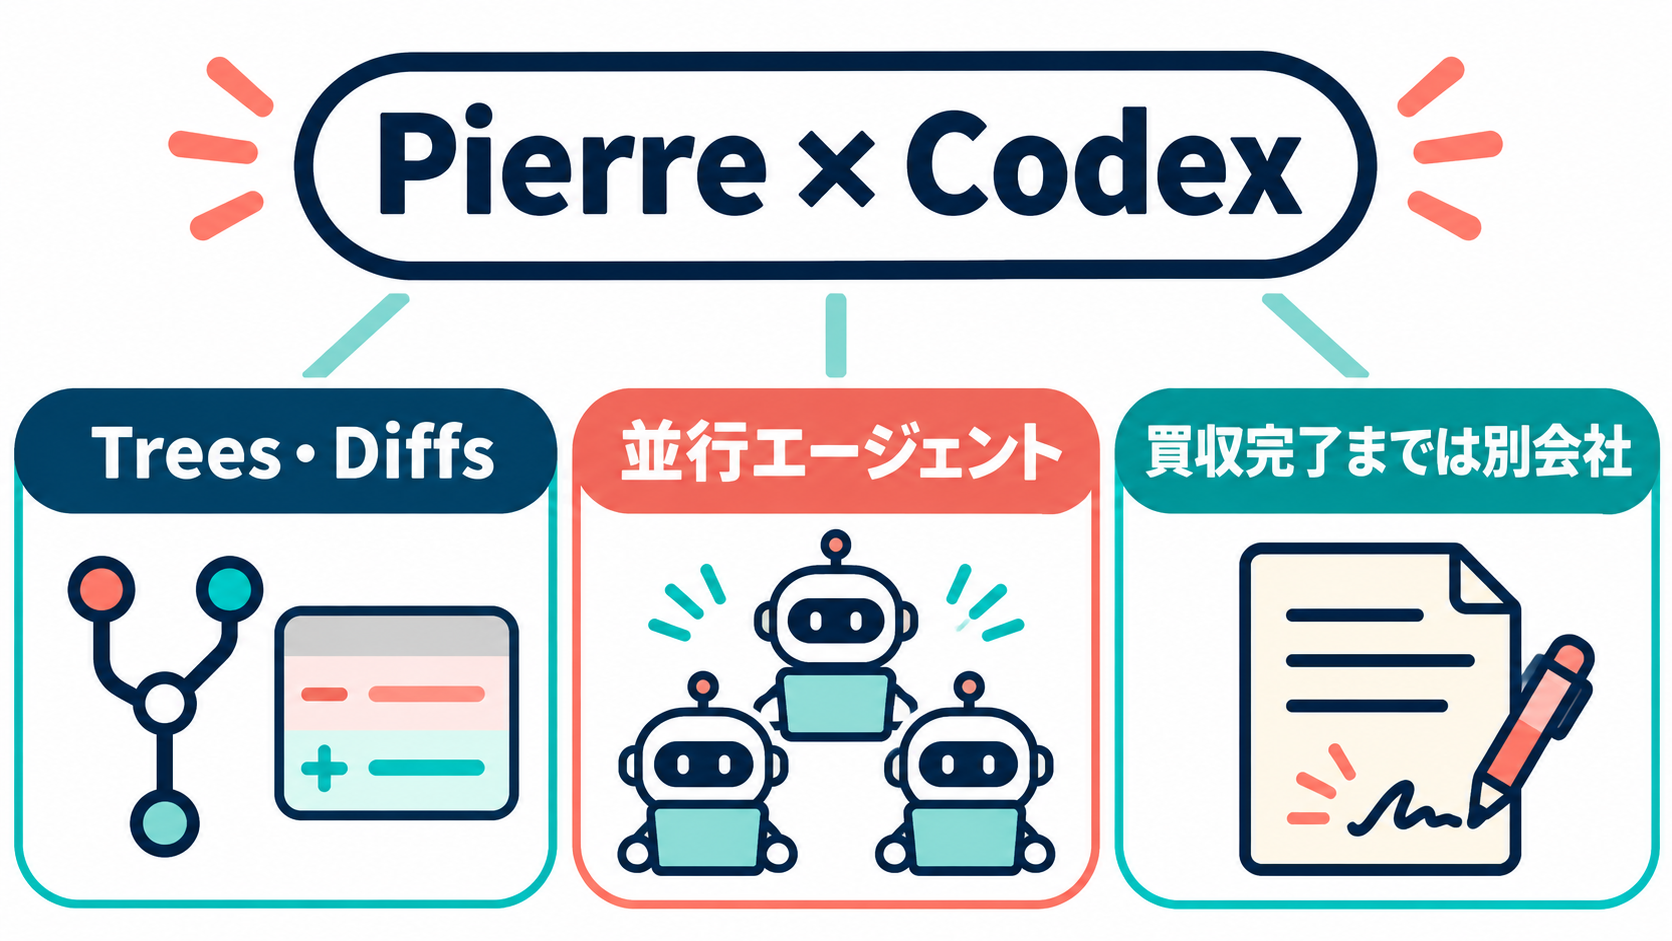
ただし、ここで「Gitがすぐなくなる」「Code Storageが今日からCodexへ統合された」と考えるのは早すぎます。発表時点では買収完了に通常の条件と規制当局の承認が必要で、完了までは両社が別会社として事業を続けます。この記事では、OpenAIのPierre買収発表で確定していること、Codex利用者にとっての意味、今すぐ変えなくてよいものを順に整理します。
- PierreとCode Storage、Trees、Diffsの関係
- Codexがすでに利用している技術
- 並行エージェントとGit管理の課題
- 買収完了前に利用者が確認すること
OpenAIのPierre買収で何が決まったか
まず、公式発表の範囲を切り分けましょう。OpenAIが公表したのはPierreを買収する契約です。Pierreは開発者向けのソース管理技術を作る企業で、Code Storageというサービスのほか、TreesとDiffsというオープンソースのライブラリを公開しています。OpenAIは、このチームと技術をCodexへ取り込み、複数のエージェントが同時に作業するための新しいソース管理体験を作る考えを示しました。
Pierreはどんな会社なのか
Pierreを理解する近道は、GitHubの代替サービスという一言で片づけないことです。公式発表では、PierreはCode Storageとオープンソースの開発者向けツールを作ってきた会社として紹介されています。特にTreesとDiffsは、リポジトリの状態やコード差分を扱うための部品です。差分とは、変更前と変更後でどこが加わり、消え、書き換わったかを表す情報。開発者のレビューだけでなく、AIエージェントが自分の変更範囲を理解する時にも重要です。
従来のGitは、人がブランチを切り、コミットを積み、レビューを通して統合する流れを得意としてきました。一方、AIエージェントが一度に複数動くと、同じファイルを別々に触ったり、短時間に多くの差分を作ったりします。人が一つずつ操作する前提の画面では、どのエージェントが何を変えたかを追いにくくなる場面があります。Pierreの技術が注目されるのは、こうした並行作業を扱う基礎に位置するからです。
CodexはTreesとDiffsを利用済み
今回の発表で重要なのは、将来利用する予定ではなく、CodexがすでにPierreのTreesとDiffsを使っているとOpenAIが説明している点です。つまり、買収後にゼロから連携を始める話ではありません。既存の技術的な接点があり、そのチームと開発をより密接に進めようとしていると読めます。
ただし、TreesやDiffsがCodexのどの画面・機能へ、どの割合で使われているかまでは公開されていません。発表から確認できるのは「利用している」という事実までです。処理速度が何倍になる、競合が自動で解消される、といった数値は示されていません。利用者としては、期待と確定情報を分けておくのが安全です。
Code Storageは当面継続する
Code Storageを使っている人にとっては、サービスがすぐ閉じるのかが気になりますよね。OpenAIの発表では、買収完了後もCode Storageを継続しながら、その機能や考え方をCodexへ持ち込む方針が示されています。一方で、料金、移行日、既存データの扱い、提供地域などの詳細日程は記載されていません。
したがって、現時点で慌ててリポジトリを移す根拠はありません。とはいえ、重要なソースコードを置くサービスでは、一般的な備えとして手元や別の正規リモートへ複製できる状態を保ち、利用規約や移行案内を追える連絡先を確認しておくと安心です。これはPierreに問題が起きたという意味ではなく、買収やサービス統合の時に行う通常の確認です。
まだ完了していないこと
発表文には、取引完了が通常の完了条件と規制当局の承認を前提とすること、完了まではOpenAIとPierreが別会社として運営されることが明記されています。この一文は小さく見えますが大切です。「OpenAI傘下になった」「データがすでに統合された」と現在形で書くのは正確ではありません。
また、買収額、Codexへの具体的な統合日、GitHubなど既存ホスティングとの関係変更も公開されていません。GitリポジトリのURL、認証方法、ブランチ運用を今すぐ変える必要はなく、CodexやCode Storageの公式更新を待つ段階です。
OpenAIのPierre買収がCodex利用者へ与える意味
読者にとって本当に知りたいのは、「明日から何をすればいいのか」でしょう。結論から言うと、通常のCodex利用者が今すぐ設定を変える必要はありません。注目したいのは、今後のCodexがコード生成だけでなく、複数エージェントが作った差分の保存、比較、レビュー、統合までを一つの流れとして扱いやすくなる可能性です。
並行エージェントでは差分管理が主役になる
一人の開発者と一つのAIチャットなら、変更結果を目で追うことは難しくありません。しかし、調査担当、実装担当、テスト担当のように複数のエージェントを並行させると、成果の速さよりも衝突を防ぐ仕組みが重要になります。同じ設定ファイルを二つのエージェントが更新した時、後から保存した側が前の変更を消してしまえば、作業量が増えても品質は上がりません。
必要なのは、エージェントごとの変更範囲を分離し、差分を小さく保ち、統合前にテストとレビューを通すことです。TreesとDiffsのような部品は、その土台を支えます。ただし、買収発表だけで自動統合や完全な競合解消が約束されたわけではありません。人のレビュー、テスト、権限管理は引き続き必要です。
GitHubやGitはなくならない
「新しいソース管理」という表現から、GitHubやGitが終わると受け取る人もいるかもしれません。公式発表は、既存サービスの終了を告知していません。OpenAIが目指すのは、エージェント中心の開発に合う体験を作ることであり、利用者が今日からGitを捨てる話ではありません。
むしろ当面は、現在のGit運用を丁寧にするほど新しい機能へ移りやすくなります。変更理由が分かるコミット、小さな差分、再現できるテスト、必要最小限の権限。この基本は、操作画面が変わっても役立ちます。Codexに大きな変更を任せる場合も、作業用ブランチやworktreeを分け、公開や本番反映の前に人が確認してください。
企業利用で確認したい3項目
企業でCodexやCode Storageを使う場合は、便利さだけでなくデータ境界を確認します。第一に、リポジトリの保存場所と契約主体。第二に、AIエージェントが読み取れる範囲。第三に、監査ログと削除・持ち出しの手順です。今回の発表だけでは新しい契約条件やデータ処理条件は確定していません。管理者は将来の製品更新時に、既存契約と新しい案内の差分を確認しましょう。
個人利用でも、秘密鍵、顧客情報、本番用認証情報をプロンプトやリポジトリへ直接置かない基本は同じです。買収が発表されたからといって、既存の安全基準を緩める理由にはなりません。
今やることと待つこと
| 今やること | 公式案内を待つこと |
|---|---|
| Gitの差分を小さく保つ | Codexへの統合日 |
| テストとレビューを残す | Code Storageの移行条件 |
| 秘密情報を分離する | 新しい料金や提供地域 |
| 公式更新を追う | 具体的な新機能 |
新しい発表を見た時は、確定した変更と将来構想を二列に分けると判断しやすくなります。今回は「買収契約」「CodexがTreesとDiffsを利用」「Code Storage継続方針」は確認済みです。一方、完了日や具体的な統合機能は未発表。ここを混ぜなければ、期待しすぎることも、必要以上に不安になることも避けられます。
エージェント開発で変わるレビュー
AIエージェントが一つだけなら、利用者は依頼と結果を一対一で追えます。ところが、複数のエージェントが別々の課題を進めると、レビューの対象は完成したコードだけでは足りません。どの時点のファイルを読んだのか、ほかの変更を取り込む前か後か、失敗した試行が残っていないかまで見ないと、動作する理由と壊れる条件を説明できないからです。
たとえば、エージェントAが認証処理を変更し、エージェントBが同じ認証処理を使う画面を追加したとします。Aの変更をBが知らないまま進めれば、両方の単体テストが通っても統合後に不具合が出るかもしれません。変更の木構造と差分を明確に持てれば、Bがどの基準点から作業したかを確認しやすくなります。TreesとDiffsという名前が示す役割は、まさにこの基準点と変更内容を扱うことです。
ただし、技術が差分を見せてくれても、どちらの変更を採用するかは要件で決まります。認証の安全性、既存利用者への影響、データ移行、失敗時の戻し方は、人が判断しなければなりません。エージェント数を増やすほど、人の仕事が消えるのではなく、判断の根拠を短時間で読める形へ整える必要が高まります。
レビューでは「誰が書いたか」より「何を根拠に変えたか」を残すと役立ちます。依頼文、参照した仕様、変更ファイル、実行したテスト、未確認項目を一つのまとまりにします。AIが作った変更でも、人が書いた変更でも、この記録があれば別の担当者が再確認できます。反対に、差分が大きすぎて目的が混ざると、新しいソース管理画面が登場してもレビューは難しいままです。
現在のGit運用で準備できること
将来のCodex更新を待つ間にも、現在のGitで準備できることがあります。最初は作業単位を小さくすること。機能追加、文章修正、依存関係更新を一つの巨大な変更へ詰め込まず、目的ごとに分けます。次に、生成ファイルと人が管理する原本を区別します。自動生成物を毎回大量に差分へ含めると、本当に確認したい変更が埋もれてしまいます。
三つ目は、エージェントごとに作業場所を分けることです。同じフォルダーを複数の処理が同時に書き換えるより、ブランチやworktreeを分けて最後に統合するほうが、意図しない上書きを減らせます。四つ目は、統合前の確認を自動化すること。静的検査、単体テスト、リンク検査、設定ファイルの構文確認など、機械で判定できる項目をそろえます。
五つ目は、結果不明の操作を再実行しないことです。公開、デプロイ、外部APIへの送信がタイムアウトした時、同じ命令をすぐ送り直すと重複が生まれることがあります。まず送信先の状態を読み、処理済みか未処理かを確かめます。並行エージェントではこの確認が特に重要です。作業速度が速いほど、重複の影響も短時間で広がるからです。
最後に、戻せる単位を決めておきます。変更前のコミット、データベースのバックアップ、設定値の控え、公開前のプレビューを残します。「失敗しない仕組み」だけでなく「失敗を見つけて戻せる仕組み」を用意すると、新しいエージェント機能を安全に試せます。
発表後に追うべき公式情報
今後はOpenAIの製品更新、Codexのドキュメント、PierreやCode Storageの案内を確認します。見るべき内容は、買収完了の発表、Code Storageの利用条件、既存アカウントやリポジトリの移行方法、Codex側の新機能、データ処理条件です。第三者の記事だけでなく、変更の主体が出す一次情報へ戻ることが大切です。
画面に新しいボタンが出たとしても、全利用者へ同時提供とは限りません。契約プラン、地域、組織ポリシー、段階的な展開で差が出る場合があります。自分の画面にない時は、障害と決める前に公式の提供条件を確認してください。逆に表示された時も、プレビュー機能なら本番リポジトリでいきなり使わず、検証用リポジトリで動作を確かめると安心です。
小さなチームでの試し方
新しい機能が提供されたら、最初は失敗しても影響の小さい課題を選びます。たとえば、説明文の修正、テストの追加、使われていないコードの候補抽出などです。本番データの削除、認証方式の全面変更、決済処理の変更を最初の実験にしないでください。機能の便利さだけでなく、止め方と戻し方を学ぶことが目的です。
一つの課題を、エージェントへの依頼、作成された差分、テスト結果、人の修正、最終コミットまで追います。次に二つのエージェントへ独立した課題を渡し、同時作業で衝突しないかを見ます。いきなり十個のエージェントを動かすより、二つで記録方法を決めたほうが、問題の原因を見つけやすいです。
確認表には、開始時のコミット、担当エージェント、変更ファイル、外部通信の有無、実行コマンド、テスト、レビュー担当、統合結果を残します。エージェントが「完了」と答えても、Gitの状態、テスト結果、公開先の実状態を読み直すまで完了にしません。この習慣は、今のCodexでも将来のソース管理機能でも役立ちます。
衝突が起きた場合は、どちらかを機械的に上書きせず、両方の依頼目的へ戻ります。Aは安全性を高め、Bは速度を上げる変更だったなら、片方だけを採用すると本来の要件を落とすかもしれません。差分表示は衝突箇所を見せますが、要件の優先順位までは決めません。ここが人のレビューで残る部分です。
個人利用者が誤解しやすい点
個人でCodexを使う人は、企業買収のニュースを見て「自分のコードが自動的にPierreへ送られるのか」と心配するかもしれません。しかし、発表文にはそのようなデータ経路の変更は書かれていません。将来の製品条件は、実際に提供される機能のドキュメントと利用規約で判断する必要があります。
また、オープンソースのTreesとDiffsをCodexが使っている事実と、Code Storageサービスを利用していることは同じではありません。公開されたライブラリを製品内部で使うことと、外部のホスティングサービスへリポジトリを保存することは別の関係です。記事やSNSで情報を読む時は、「ライブラリ」「サービス」「会社」を分けてください。
買収後に新しい保存機能が登場した場合も、保存先、公開範囲、削除方法、エクスポート方法を確認してから使います。無料試用や初期設定で公開範囲が変わらないか、組織のリポジトリを個人アカウントへ移してよいかも確認しましょう。新機能を試す時ほど、コードの所有者と権限の境界を曖昧にしないことが大切です。
今回の発表を一文で読むなら
今回の発表を短く言うと、OpenAIは、AIエージェントが並行してコードを変更する時代に合うソース管理をCodexへ組み込むため、すでに利用しているTreesとDiffsの開発元Pierreを買収する契約を結んだ、となります。ここには、現在確認できる事実と、OpenAIが示した方向性の両方が入っています。
逆に、「OpenAIがGitを廃止した」「GitHubの代替が完成した」「Code StorageがCodexへ統合済み」という言い方は、発表内容を超えています。ニュースの見出しは短くても、実際の判断では完了条件、提供時期、データの扱いを確認しましょう。
発表を社内へ共有する時は、日付と出典URLを添え、「現在」「将来方針」「未発表」の三段に分けると伝わりやすくなります。現在は買収契約と既存技術の利用、将来方針はCodexへの機能導入、未発表は完了日・料金・移行条件です。この分け方なら、後日新しい情報が出た時も、変わった部分だけ更新できます。
また、記事や資料の更新日を残してください。買収のように段階がある出来事は、契約発表、取引完了、製品統合、既存サービスの条件変更が別の日に起こります。一度書いた説明を永続的な事実として扱わず、公式発表が増えた時にどの文章を見直すか分かる状態にしておきましょう。
個人の学習目的なら、公開リポジトリを複製し、同じ小さな課題を単独作業と並行作業で試すと違いを理解しやすいです。成功だけでなく、競合した箇所、レビューにかかった時間、戻した変更も記録します。実験結果を一般的な性能保証へ広げず、自分の環境で確認した範囲として扱ってください。
そして、試した機能名と版、確認日も一緒に残します。AI開発ツールは更新が速いため、同じ手順でも後日結果が変わることがあります。再現条件があれば、機能改善なのか設定差なのかを見分けやすくなります。
Pierre買収のよくある質問
Q1. OpenAIによるPierre買収は完了しましたか?
A. 2026年11月4日時点の発表は買収契約です。完了には通常の条件と規制当局の承認が必要で、完了までは別会社として運営されます。
Q2. Code Storageは終了しますか?
A. 公式発表では買収完了後も継続する方針です。具体的な移行日や契約変更は示されていないため、今後の公式案内を確認してください。
Q3. GitHubから移行する必要がありますか?
A. その必要を示す発表はありません。現在のGit運用を続け、Codexの新機能や移行案内が出た時に比較すれば十分です。
Q4. CodexはすでにPierreの技術を使っていますか?
A. OpenAIはCodexがTreesとDiffsを利用していると説明しています。ただし、利用箇所や性能数値は公開していません。
Q5. 今すぐ設定変更は必要ですか?
A. 通常の利用者が直ちに設定を変える必要はありません。差分を小さく保ち、テストとレビューを続けながら公式更新を待ちましょう。
OpenAIのPierre買収まとめ
OpenAIのPierre買収発表は、Codexがコードを書く道具から、複数のエージェントによる変更を保存・比較・統合する開発基盤へ広がろうとしていることを示します。PierreのTreesとDiffsはすでにCodexで利用され、Code Storageも継続方針です。
一方、買収は完了前で、具体的な統合日や料金、移行条件は未発表です。今はGitHubやGitを急いで置き換える時期ではありません。現在のリポジトリ管理、テスト、レビュー、秘密情報の分離を整え、OpenAIとPierreの公式案内を確認する。それが、変化へ備えるいちばん堅実な行動です。